OBJETIVOS
Comprender qué es la ciencia de datos y sus principales aplicaciones en industrias.
·
Comprender el
proceso de ciencia de datos y la importancia de la calidad
·
Aplicar
técnicas para la adquisición y limpieza de datos.
·
Realizar
análisis exploratorio de datos (EDA).
·
Realizar
visualizaciones para entender patrones en los datos.
· Comprender los conceptos básicos del aprendizaje automático, aprendizaje profundo y la importancia de los datos desde los cuales los algoritmos aprenden.
| Basicos | |
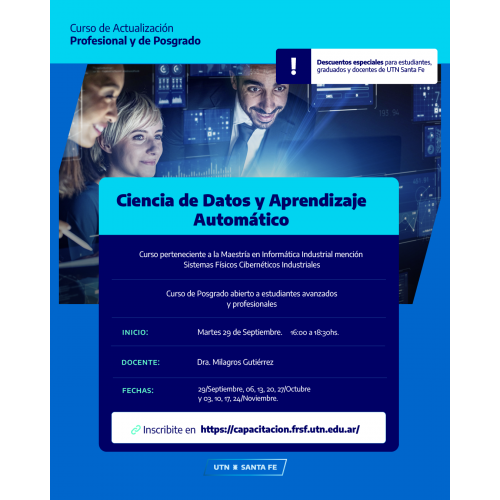
| DURACIÓN EN HORAS | 60hs totales. COMIENZO: 29/09/2026 Cursado: todos los martes de octubre y noviembre de 16:30 a 18hs. |
| CONTENIDOS DEL CURSO | Unidad 1: Introducción a Ciencia de datos (12hs) Concepto de Ciencia de datos. El ciclo de vida de un proyecto de ciencia de datos. Roles y habilidades de un científico de datos. Introducción a Python y sus bibliotecas clave (NumPy, Pandas, Matplotlib). Adquisición y Limpieza de Datos. Fuentes de datos (bases de datos, APIs, archivos CSV). Manipulación de datos con Pandas. Limpieza de datos: tratamiento de valores faltantes, duplicados y datos erróneos. Unidad 2: Exploración y Visualización de Datos (12hs) Técnicas de EDA con Pandas. Visualización de datos con Matplotlib y Seaborn. Interpretación de gráficos (distribución, correlación, etc.). Casos de estudio de visualización de datos. Unidad 3: Introducción al Aprendizaje Automático (12hs) Concepto de aprendizaje automático. Diferentes tipos de aprendizaje: supervisado, no supervisado, por refuerzo, semi-supervisado. Algoritmos supervisados: Regresión lineal, clasificación. Algoritmos no supervisados: Agrupamiento (clustering). Implementación básica en Python con Scikit-learn. Evaluación de modelos para el aprendizaje automático: métricas. Principales problemas del aprendizaje automático. Unidad 4: Redes neuronales artificiales (12 hs) Concepto básico de neurona artificial. Redes neuronales artificiales, arquitectura de una red. Funciones de activación. Entrenamiento de redes neuronales: backpropagation. Concepto de cross validation, datos de entrenamiento y de validación. Funciones de pérdida, costo y optimización. Tasa de aprendizaje. Inconvenientes frecuentes y soluciones a los problemas: overfitting y underfitting. Técnicas de regularización: earlystopping y dropout. Aprendizaje profundo. Unidad 5: Redes neuronales convolucionales (12 hs) Introducción a las redes neuronales convolucionales (CNN): convoluciones, pooling, y capas fully connected. Arquitectura típica de una CNN. Aplicaciones de CNN en visión por computadora. Implementación práctica de una CNN básica con Python y TensorFlow/Keras. Redes preentrenadas: Análisis y comparación de las propuestas del mercado. |
Ciencia de Datos y Aprendizaje Automático.
- Referencia: curso
- Disponibilidad: 100
-
$350,000.00